数据挖掘实验三
一、实验目的
掌握ID3算法的原理。
二、实验要求
通过本实验应达到如下要求:
-
掌握决策树相关的基本概念,理解信息增益。
-
熟练使用Python或其他工具实现 ID3 算法。
三、实验器材
(1)计算机一台。
(2)Python或其他编程工具。
四、实验内容
决策树
决策树算法采用树形结构,使用层层推理来实现最终的分类。决策树由下面几种元素构成:
- 根节点:包含样本的全集。
- 内部节点:对应特征属性测试。
- 叶节点:代表决策的结果。
类型
- 分类树分析是当预计结果可能为离散类型(例如三个种类的花,输赢等)使用的概念。
- 回归树分析是当局域结果可能为实数(例如房价,患者住院时间等)使用的概念。
- CART 分析是结合了上述两者的一个概念。CART 即 Classification And Regression Trees.
- CHAID。
学习的步骤
特征选择
特征选择决定了使用哪些特征来做判断。在训练数据集中,每个样本的属性可能有很多个,不同属性的作用有大有小。因而特征选择的作用就是筛选出跟分类结果相关性较高的特征,也就是分类能力较强的特征。
在特征选择中通常使用的准则是:信息增益。
决策树生成
选择好特征后,就从根节点触发,对节点计算所有特征的信息增益,选择信息增益最大的特征作为节点特征,根据该特征的不同取值建立子节点;对每个子节点使用相同的方式生成新的子节点,直到信息增益很小或者没有特征可以选择为止。
决策树剪枝
剪枝的主要目的是对抗「过拟合」,通过主动去掉部分分支来降低过拟合的风险。
典型算法
ID3 算法
ID3 是最早提出的决策树算法,他就是利用信息增益来选择特征的。
C4.5 算法
他是 ID3 的改进版,他不是直接使用信息增益,而是引入“信息增益比”指标作为特征的选择依据。
CART(Classification and Regression Tree)
这种算法即可以用于分类,也可以用于回归问题。CART 算法使用了基尼系数取代了信息熵模型。
优点
- 决策树易于理解和解释,可以可视化分析,容易提取出规则;
- 可以同时处理标称型和数值型数据;
- 比较适合处理有缺失属性的样本;
- 能够处理不相关的特征
- 测试数据集时,运行速度比较快;
- 在相对短的时间内能够对大型数据源做出可行且效果良好的结果。
缺点
- 容易发生过拟合(随机森林可以很大程度上减少过拟合);
- 容易忽略数据集中属性的相互关联;
- 对于那些各类别样本数量不一致的数据,在决策树中,进行属性划分时,不同的判定准则会带来不同的属性选择倾向;信息增益准则对可取数目较多的属性有所偏好(典型代表 ID3 算法),而增益率准则(CART)则对可取数目较少的属性有所偏好,但 CART 进行属性划分时候不再简单地直接利用增益率尽心划分,而是采用一种启发式规则)(只要是使用了信息增益,都有这个缺点,如 RF)。
- $ID3$ 算法计算信息增益时结果偏向数值比较多的特征。
ID3 算法
定义
$ID3$ 算法是决策树的一种,基于奥卡姆剃刀原理进行实现,即用尽量少的东西去完成尽可能多的东西。
在信息论中,期望信息越小, 那么信息增益就越大,从而纯度就越高。$ID3$ 算法的核心思想就是以信息增益来度量属性的选择,选择分裂后信息增益最大的属性进行分裂。该算法采用自顶向下的贪婪搜索(它也是贪婪算法噢)遍历可能的决策空间。
信息熵与信息增益
信息熵
在信息学中,熵是对不确定性的度量。信息熵指离散随机事件出现的概率。一个系统越是有序,则信息熵就越低。反之,一个系统越是混乱,它的信息熵就越高。所以信息熵可以被认为是反应系统有序化程度的一个度量指标。
假设一个随机变量 $X$ 的取值为 $X = {x_1, x_2, ……, x_n}$,每一种取到的概率分别是${p_1,p_2,……,p_n}$,那么,X的熵定义为: \(H(X) = -\sum_{i = 1}^np_ilog_2p_i\) 意思是一个变量的变化情况越多,那么它携带的信息量就越大。
对于一个分类系统来说,类别C 是变量,它的取值是 $C_1, C_2,……,C_n$,而每一个类别出现的概率分别是: $P(C_1), P(C_2),……,P(C_n)$
此时分类系统的熵就可以表示为:(这里的 n 就是类别的总数噢) \(H(C) = -\sum_{i = 1}^nP(C_i)log_2P(C_i)\) 信息增益
在决策树分类问题中,信息增益是针对一个特定的分支标准 T, 计算原有数据的信息熵与引入该分支标准后的信息熵之差。信息增益的定义如下: \(IG(T) = Entropy(S) - Entropy(S|T)\)
\[或:IG(S|T) = Entropy(S) - \sum_{value(T)}\frac{|S_v|}{S}Entropy(S_v)\] 信息增益其实就是计算在分类前后两个系统总的信息熵的变化。(
算法思想
$ID3$ 算法的基本思想是:首先计算出原始数据集的信息熵, 然后依次将数据中的每一个特征作为分支标准,并计算其相对于原始数据的信息增益,选择最大信息增益的分支标准来划分数据,因为信息增益越大,区分样本的能力就越强,越具有代表性。然后重复上述过程从而生成一颗决策树,很显然这时一种自顶向下的贪心策略。
C4.5 算法
$C4.5$ 算法是对 $ID3$ 算法的改进,$C4.5$ 克服了 $ID3$ 算法的2个缺点:
1.用信息增益选择属性时偏向于选择分支比较多的属性值,即取值多的属性
2.不能处理连续属性。
对于离散特征,$C4.5$ 算法不直接使用信息增益,而是使用“增益率”来选择最优的分支标准,增益率的定义如下: \(GainRatio(D, T) = \frac{Gain(D,T)}{IV(T)}\) 其中, $IV(T) = -\sum_{v=1}^V\frac{|D^v|}{|D|}log_{2}\frac{|D^v|}{|D|}$,称作分支标准 $T$ 的固有值。作为分支标准的属性可取值越多, 则$IV$ 的值越大。需要注意的是,增益率准则对可取值数目较少的属性有所编号,因此 $C4.5$ 算法并不是直接选择增益率最大的属性作为分支标准,而是先从侯选属性中找出信息增益高于平均水平的属性,再从中选择增益率最高的。
$C4.5$ 算法处理连续属性的方法是先把连续属性转换为离散属性再进行处理。虽然本质上属性的取值是连续的,但对于有限的采样数据它是离散的,如果有N条样本,那么我们有 $N - 1$ 种离散化的方法。
CART 算法
$CART$ 算法既可以用于创建分类树, 也可以用于创建回归树。$CART$ 算法的重要特点包含以下三个方面:
1.二分:在每次的判断过程中,都是对样本数据进行二分。$CART$ 算法是一种二分递归分割技术,把当前样本划分为两个子样本,使得生成的每个非叶子结点都有俩个分支,因此,$CART$ 算法生成的决策树是结构简洁的二叉树。由于$CART$ 算法构成的是一个二叉树,它在每一步的决策时只能是“是”或者“否”,即使一个 $feature$ 有多个取值,也是把数据分为两个部分。
2.单变量分割:每次最优划分都是针对单个变量。
3.剪枝策略:$CART$ 算法的关键点,也是整个 $Tree-Based$ 算法的关键步骤。剪枝过程特别重要,所以在最优决策树生成过程中占有重要地位。有研究表明,剪枝过程的重要性要比树生成过程更为重要,对于不同的划分标准生成的最大树($Maximum Tree$),在剪枝之后都能够保留最重要的属性划分,差别不大。反而是剪枝方法对于最优树的生成更为关键。
算法原理
1.选一个自变量,再选取的一个值,把维空间划分为两部分,一部分的所有点都满足,另一部分的所有点都满足,对非连续变量来说属性值的取值只有两个,即等于该值或不等于该值。
2.递归处理,将上面得到的两部分按步骤 1 重新选取一个属性继续划分,直到把整个维空间都划分完。在划分时候有一个问题,它是按照什么标准来划分的 ? 对于一个变量属性来说,它的划分点是一对连续变量属性值的中点。假设个样本的集合一个属性有个连续的值,那么则会有个分裂点,每个分裂点为相邻两个连续值的均值。每个属性的划分按照能减少的杂质的量来进行排序,而杂质的减少量定义为划分前的杂质减去划分后的每个节点的杂质量划分所占比率之和。而杂质度量方法常用Gini指标,假设一个样本共有类,那么一个节点的Gini不纯度可定义为:
\(Gini(A)\ =\ 1\ -\ \sum_{i=1}^{C}p_i^2\)
其中, 是分类
出现的概率,$n$ 是分类的数目。$Gini(D)$ 反映了从数据集 $D$ 中随机抽取两个样本,其类别标记不一致的概率。因此,Gini(D)越小,则数据集D的纯度越高。
3.剪枝处理,决策树为什么要剪枝?原因是避免决策树过拟合 $(Overfitting)$ 样本。前面的算法生成的决策树非常详细并且庞大,每个属性都被详细地加以考虑,决策树的树叶节点所覆盖的训练样本都是“纯”的。因此用这个决策树来对训练样本进行分类的话,你会发现对于训练样本而言,这个树表现完好,误差率极低且能够正确得对训练样本集中的样本进行分类。训练样本中的错误数据也会被决策树学习,成为决策树的部分,但是对于测试数据的表现就没有想象的那么好,或者极差,这就是所谓的过拟合 $(Overfitting)$ 问题。$Quinlan$ 教授试验,在数据集中,过拟合的决策树的错误率比经过简化的决策树的错误率要高。
剪枝可以分为两种:预剪枝 $(Pre-Pruning)$ 和后剪枝 $(Post-Pruning)$ ,下面我们来详细学习下这两种方法: $PrePrune$:预剪枝,及早的停止树增长,方法可以参考见上面树停止增长的方法。 $PostPrune$:后剪枝,在已生成过拟合决策树上进行剪枝,可以得到简化版的剪枝决策树。 其实剪枝的准则是如何确定决策树的规模,可以参考的剪枝思路有以下几个:
- 使用训练集合 $(Training Set)$ 和验证集合 $(Validation Set)$,来评估剪枝方法在修剪结点上的效用。
- 使用所有的训练集合进行训练,但是用统计测试来估计修剪特定结点是否会改善训练集合外的数据的评估性能,如使用 $Chi-Square(Quinlan,1986)$测试来进一步扩展结点是否能改善整个分类数据的性能,还是仅仅改善了当前训练集合数据上的性能。
- 使用明确的标准来衡量训练样例和决策树的复杂度,当编码长度最小时,停止树增长,如 $MDL(Minimum Description Length)$ 准则。
随机森林
定义
随机森林是由很多决策树构成的,不同决策树之间没有关联。
当我们进行分类任务时,新的输入样本进入,就让森林中的每一棵决策树分别进行判断和分类,每个决策树会得到一个自己的分类结果,决策树的分类结果中哪一个分类最多,那么随机森林就会把这个结果当做最终的结果。
数据采样
作为一种 $Bagging$ 集成算法,随机森林同样采用有放回的采样,对于总体训练集 $T$,抽样一个子集 $Tsub$ 作为训练样本集。除此之外,假设训练集的特征个数为 $d$,每次仅选择 $k(k<d)$ 个构建决策树。因此,随机森林除了能够做到样本扰动外,还添加了特征扰动,对于特征的选择个数,推荐值为 $k = \log_2 d$ 。
(由于篇幅有限,不再对 $Bagging$ 和 $Boosting$ 集成算法进行介绍了。)
树的构建
每次根据采样得到的数据和特征构建一棵决策树。在构建决策树的过程中,会让决策树生长完全而不进行剪枝。构建出的若干棵决策树则组成了最终的随机森林。
优点
1. 由于随机森林引入了样本扰动和特征扰动,从而很大程度上提高了模型的泛化能力,尽可能地避免了过拟合现象的出现。
2. 随机森林可以处理高维数据,无需进行特征选择,在训练过程中可以得出不同特征对模型的重要性程度。
3. 随机森林的每个基分类器采用决策树,方法简单且容易实现。同时每个基分类器之间没有相互依赖关系,整个算法易并行化。
缺点
1. 随机森林已经被证明在某些噪音较大的分类或回归问题上会过拟合。
2 .对于有不同取值的属性的数据,取值划分较多的属性会对随机森林产生更大的影响,所以随机森林在这种数据上产出的属性权值是不可信的。
选取数据集
| 天气 | 温度 | 湿度 | 风速 | 活动 |
| 晴 | 炎热 | 高 | 弱 | 取消 |
| 晴 | 炎热 | 高 | 强 | 取消 |
| 阴 | 炎热 | 高 | 弱 | 进行 |
| 雨 | 适中 | 高 | 弱 | 进行 |
| 雨 | 寒冷 | 正常 | 弱 | 进行 |
| 雨 | 寒冷 | 正常 | 强 | 取消 |
| 阴 | 寒冷 | 正常 | 强 | 进行 |
| 晴 | 适中 | 高 | 弱 | 取消 |
| 晴 | 寒冷 | 正常 | 弱 | 进行 |
| 雨 | 适中 | 正常 | 弱 | 进行 |
| 晴 | 适中 | 正常 | 强 | 进行 |
| 阴 | 适中 | 高 | 强 | 进行 |
| 阴 | 炎热 | 正常 | 弱 | 进行 |
| 雨 | 适中 | 高 | 强 | 取消 |
简述熵(体现系统中的不确定性)的概念
(上面已经说过了哦
代码
熵的计算。
def calcShannonEnt(dataSet):
    numEntries = len(dataSet)
    labelCounts = {}
    for fearVec in dataSet:
        currentLabel = fearVec[-1]                  #获取最后一竖排(即YES OR NO)
        if currentLabel not in labelCounts.keys():
            labelCounts[currentLabel] = 0
        labelCounts[currentLabel] += 1              #通过字典的键值对 进行计数
    shannonEnt = 0.0
    for key in labelCounts:
        prob = float(labelCounts[key]) / numEntries #出现的概率
        shannonEnt -= prob * log(prob, 2)           #计算数据集的总熵
    return shannonEnt
根据选定的元素对数据进行划分。
# 划分数据集
def splitDataSet(dataSet, axis, value):
    retDataSet = []
    for featVec in dataSet:
        if featVec[axis] == value:                  #获取到指定 VALUE(属性)的位置
            reducesFeatVec = featVec[:axis]
            reducesFeatVec.extend(featVec[axis + 1:])       #扩充元素
            retDataSet.append(reducesFeatVec)               #去掉指定位置 axis 的元素
    #print("retDataSet:",retDataSet)
    return retDataSet
根据信息熵的增量来确定划分方式。
# 选择最好的数据集划分方式
def chooseBestFeatureTpSplit(dataSet):
    '''
        此函数中调用的数据满足以下要求
        1,数据必须是一种由列表元素组成的列表,而且所有列表元素都要具有相同的数据长度
        2,数据的最后一列或者实例的最后一个元素是当前实例的类别标签
    :param dataSet:
    :return:
    '''
    numFeatures = len(dataSet[0]) - 1           #特征的数目
    # 原始的熵
    baseEntropy = calcShannonEnt(dataSet)
    bestInfoGain = 0.0                          #信息增益
    bestFeature = -1
    for i in range(numFeatures):
        # 创建唯一的分类标签列表
        featList = [example[i] for example in dataSet]      #取出每个属性的值
        uniqueVals = set(featList)                          #SET 去重
        newEntropy = 0.0
        for value in uniqueVals:
            # 计算每种划分方式的信息熵,并对所有唯一特征值得到的熵求和
            subDataSet = splitDataSet(dataSet, i, value)
            prob = len(subDataSet) / float(len(dataSet))
            # 按照特征分类后的熵
            newEntropy += prob * calcShannonEnt(subDataSet)
        infoGain = baseEntropy - newEntropy
        if (infoGain > bestInfoGain):                       #取出其中的最大值
            # 计算最好的信息增益,信息增益越大,区分样本的能力越强,根据代表性
            bestInfoGain = infoGain
            bestFeature = i
    return bestFeature
按照分类后的类别进行排序。
# 按照分类后类别数量排序
def majorityCnt(classList):
    classCount = {}
    for vote in classList:
        if vote not in classCount.keys():   #通过字典 区分YES OR NO
            classCount[vote] = 0
        classCount[vote] += 1
    sortedClassCount = sorted(classCount.items(),
                              key=operator.itemgetter(1), reverse=True)
    return sortedClassCount[0][0]
创建树的过程。
# 创建树的函数代码
def createTree(dataSet, labels):
    '''

        :param dataSet:  输入的数据集
        :param labels:  标签列表(包含了数据集中所有特征的标签)
        :return:
        '''
    # classList 包含了数据集中所有类的标签
    classList = [example[-1] for example in dataSet]
    print("classList:",classList)
    print()
    # 类别完全相同则停止继续划分
    if classList.count(classList[0]) == len(classList):
        return classList[0]
    # 遍历完所有特征时返回出现次数最多的
    if len(dataSet[0]) == 1:
        return majorityCnt(classList)
    bestFeat = chooseBestFeatureTpSplit(dataSet)
    bestFeatLabel = labels[bestFeat]
    # 字典myTree存储了树的所有信息,这对于后面绘制树形图很重要
    myTree = {bestFeatLabel: {}}
    del (labels[bestFeat])              #删除标签
    # 得到列表包含的所有属性值
    featValues = [example[bestFeat] for example in dataSet]     #取出某个属性的所有的值
    uniqueVals = set(featValues)                                #去重
    for value in uniqueVals:
        subLabels = labels[:]
        myTree[bestFeatLabel][value] = createTree(splitDataSet(dataSet, bestFeat, value),
                                                  subLabels)

    return myTree
图像的绘制过程。
# 主函数
def createPlot(inTree):
    # 创建一个新图形并清空绘图区
    fig = plt.figure(1, facecolor='white')
    fig.clf()
    axprops = dict(xticks=[], yticks=[])
    createPlot.ax1 = plt.subplot(111, frameon=False, **axprops)  # no ticks
    # createPlot.ax1 = plt.subplot(111, frameon=False) #ticks for demo puropses
    plotTree.totalW = float(getNumLeafs(inTree))
    plotTree.totalD = float(getTreeDepth(inTree))
    plotTree.xOff = -0.5 / plotTree.totalW
    plotTree.yOff = 1.0
    plotTree(inTree, (0.5, 1.0), '')
    plt.show()
简述信息增益的概念:
(上面已经说过了哦
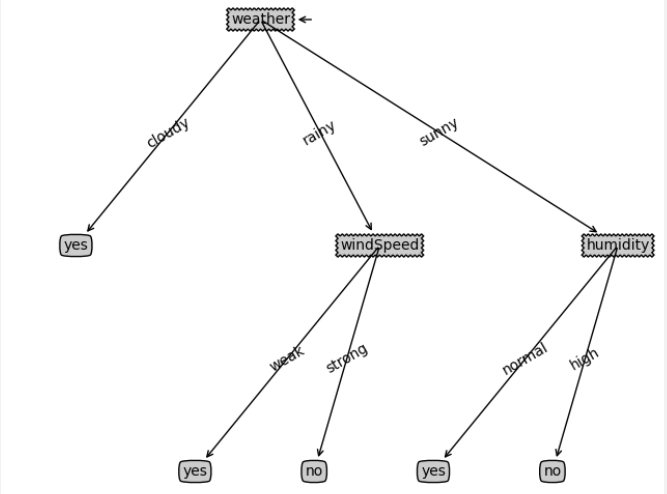
最后得到的决策树
五、实验心得
通过这次实验,学会了如何使用 $ID3$ 算法来构建决策树,同时对 $C4.5$ 和 $CART$ 算法有了一个大概的了解,收获颇丰。